Свежий результат не заменяет дизайн исследования
21 октября 2026 года Magnite опубликовала разбор данных Cint с сопоставлением агрегированных кампаний и benchmarks. Это партнёрская публикация о наблюдаемых результатах. Из такого сравнения само по себе не следует, что произвольная другая платформа дала бы хуже на той же задаче.
Для причинного вывода важны способ назначения рекламы, исходные различия групп и возможное влияние других контактов. Сравнение с нормой отвечает на другой вопрос: как результат выглядит относительно выбранной базы. Нельзя переименовать его в рандомизированный тест закупки.
В MRC Outcomes and Data Quality Standards, финальная версия сентября 2022 года, выборка и опросные методы рассматриваются через дизайн, покрытие, представительность и смещения. Это независимый методический контекст, не аудит исследования Magnite или Cint.
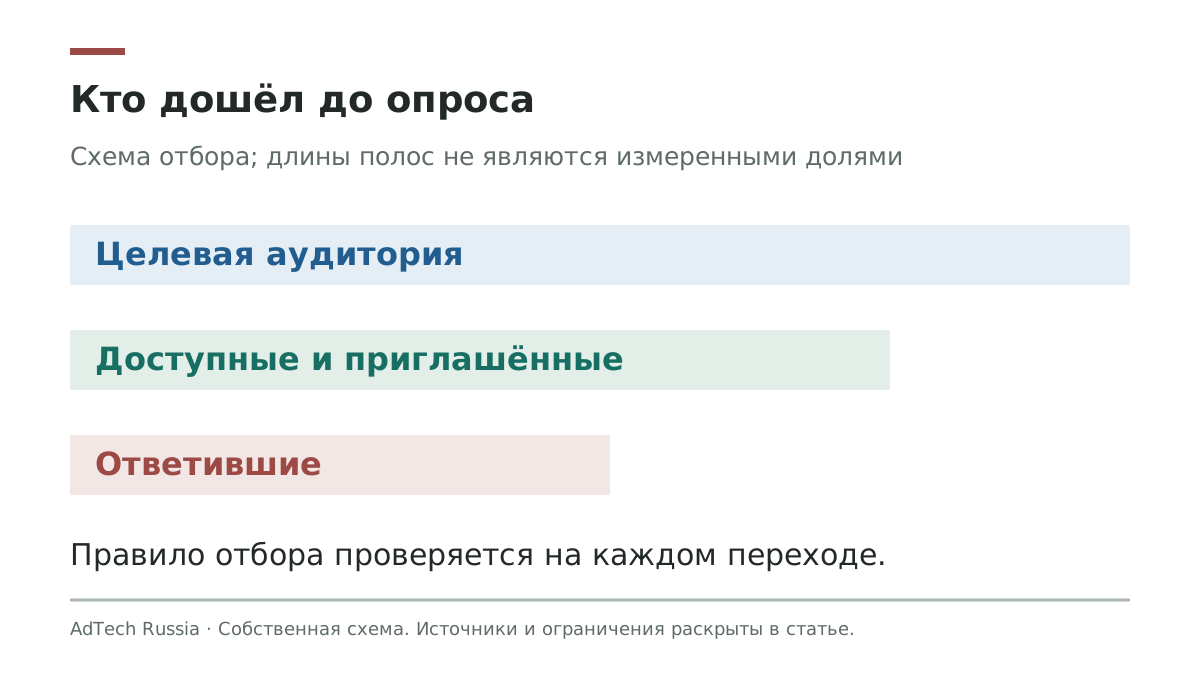
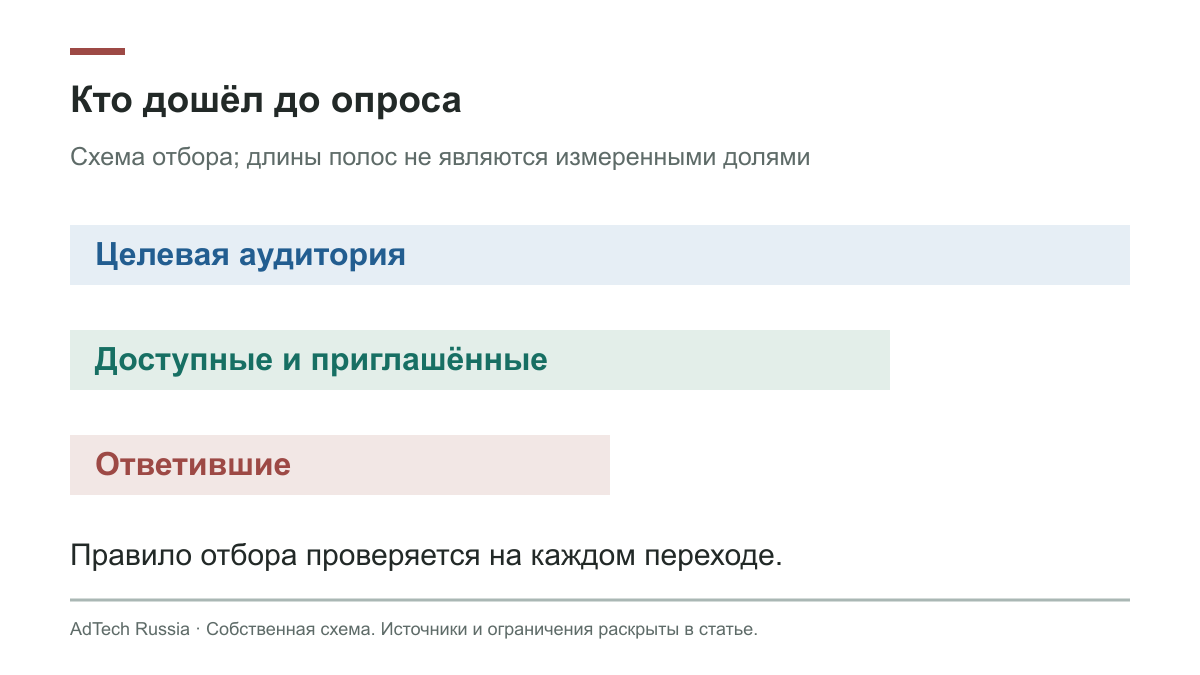
Кто дошёл до опроса
Целевая аудитория кампании, люди с измеримым контактом, доступные панели участники и фактически ответившие могут быть разными совокупностями. На каждом переходе требуется объяснить отбор. Большая исходная поставка не гарантирует большую или представительную выборку ответов.
Например, более заинтересованные в категории люди могут чаще завершать опрос. Если их доля различается между группами, разница ответов может отражать состав. Это возможный механизм смещения, а не утверждение о поведении всех панелей или о дефекте конкретного поставщика.
Рандомизация рекламного воздействия и случайный отбор приглашённых являются разными процедурами. Даже корректное назначение воздействия не отменяет проверку того, кто ответил. В карточке сохраняются доступный объём, приглашения, завершённые анкеты и основания исключений для каждой группы.
Учебная разница с разной исходной базой
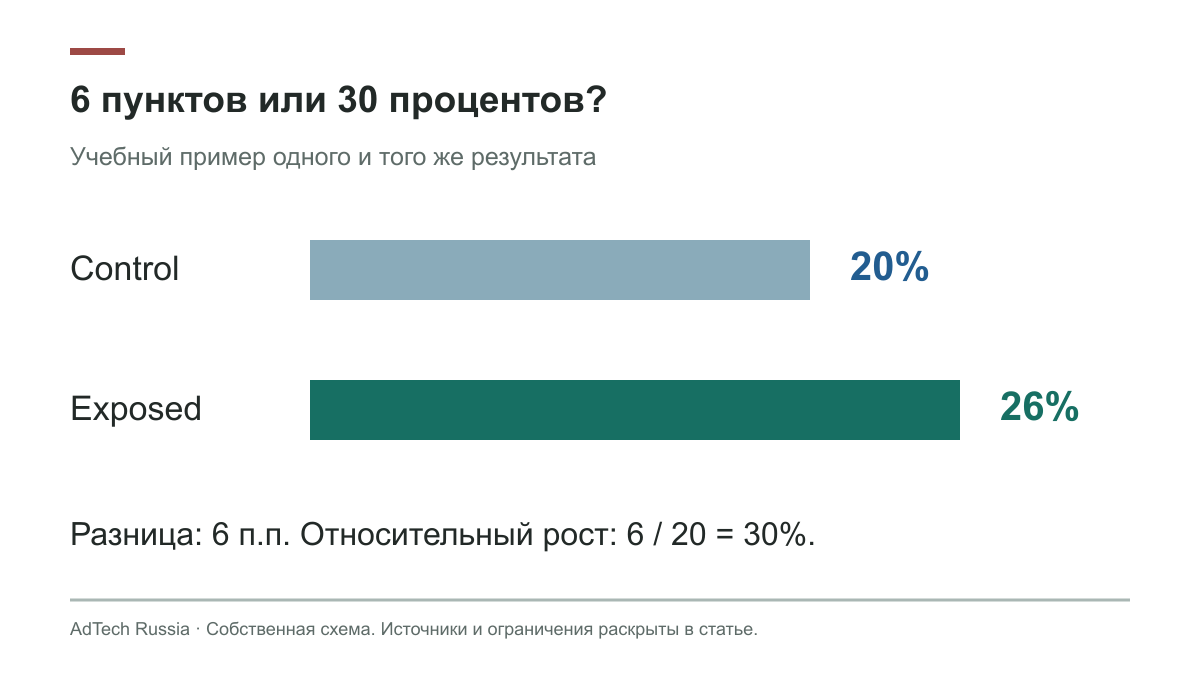
В вымышленном опросе о бренде знают 20% контрольной группы и 26% exposed. Разница составляет 6 процентных пунктов. Относительно контрольной базы это рост на 30%. Все числа учебные; они не описывают результаты какой-либо площадки.
Запись «lift 30%» без базы позволяет представить эффект иначе, чем запись «6 процентных пунктов». В отчёте нужны обе исходные доли, абсолютная разница и точное определение относительного показателя. При очень малой контрольной доле относительный рост может выглядеть особенно большим.
| Поле | Что запрашивается |
|---|---|
| Метрика | Вопрос анкеты, варианты ответа и порядок |
| База | Доли control/exposed и число ответивших |
| Отбор | Как назначали контакт и приглашали участников |
| Сопоставимость | Исходные признаки, пересечения и ограничения |
| Неопределённость | Метод оценки интервала и проверки разницы |
Число ответов без дизайна не даёт универсальной достаточности. Маленькая разница требует своей точности, сильное взвешивание может уменьшить эффективную информацию. Для вывода о разнице важно оценивать именно её неопределённость; простое визуальное сравнение двух отдельных интервалов не заменяет статистическую процедуру.
Вес исправляет только то, что удалось учесть
Предположим, в целевой аудитории две учебные возрастные категории представлены поровну, а среди ответивших доля одной достигает 80%. Здесь речь о составе аудитории, а не о соотношении control и exposed. Взвешивание может скорректировать известный перекос при обоснованных данных о структуре. Оно не восстанавливает автоматически ненаблюдаемые мотивы участия и отсутствующие группы.
Поэтому заказчику нужны переменные взвешивания, источник целевой структуры и ограничения проекции. Фраза «выборка нормализована» недостаточна. Важно понять, на какую аудиторию распространяется вывод и какие части кампании остаются вне исследования.
Если control создан модельным подбором, это указывается отдельно от случайного назначения. Качественный подбор может быть полезным, но его предпосылки требуется проверить. Одинаковый возраст и пол не гарантируют одинаковую исходную склонность к покупке или отношение к бренду.
Benchmark не является второй контрольной группой
Справка Cint о benchmarks, обновлённая 23 октября, различает исторические базы и разрезы по стране, индустрии, аудитории и среде. Здесь используются определения страницы, а не числа закрытой или непрочитанной таблицы. Методические изменения могут влиять на сопоставимость разных периодов.
Дополнительно документация Outcomes Measurement поясняет, что опросный Brand Lift и транзакционный Sales Lift опираются на разные базы. Их соседство в интерфейсе не делает ответивших участников теми же людьми, по которым посчитаны продажи.
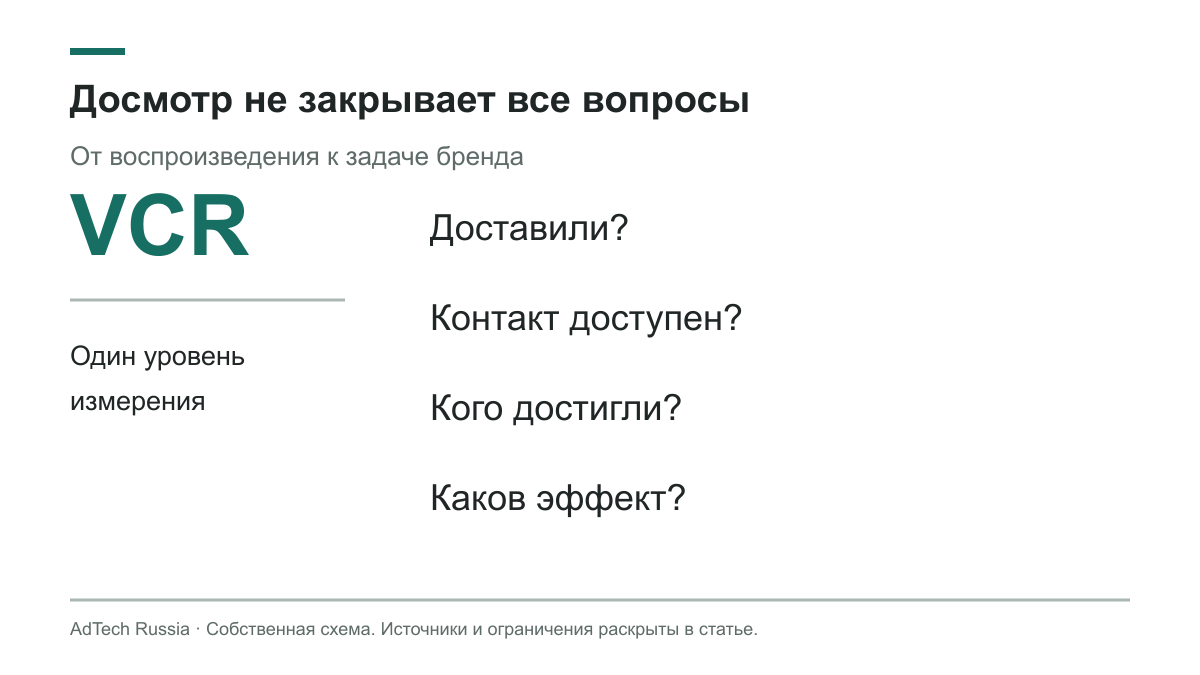
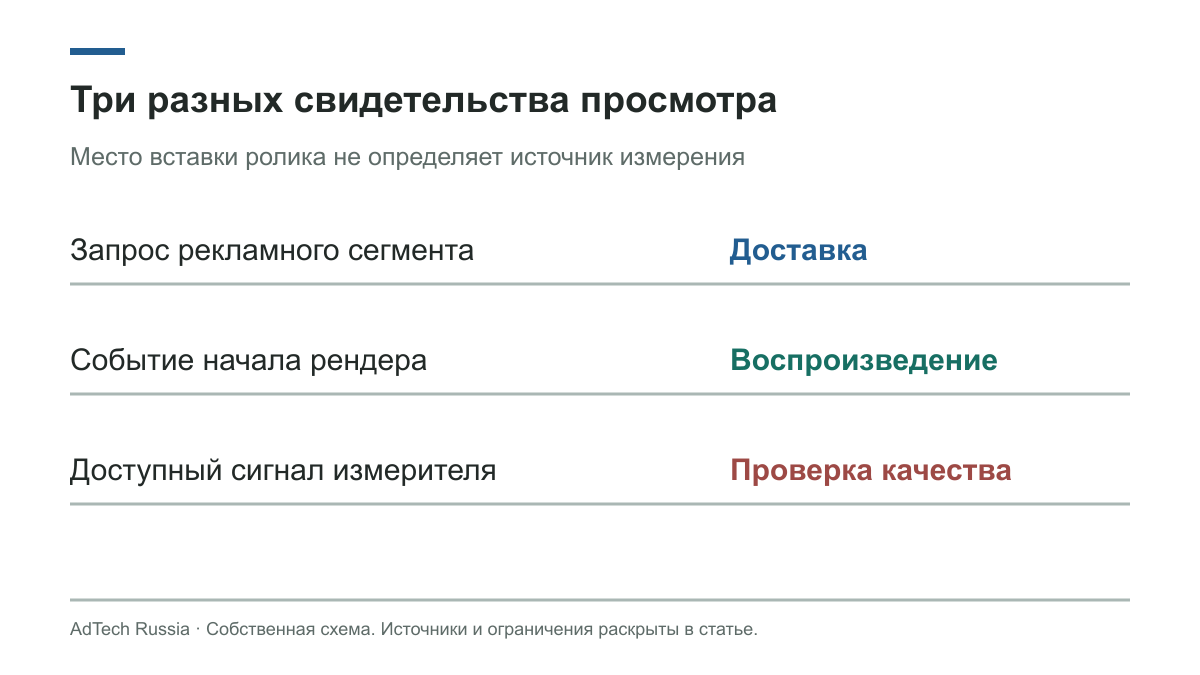
Для российской кампании аналитик запрашивает карточку до запуска, а исследователь согласует выборку, вопрос и базу сравнения. В итоговом выводе явно названы аудитория, период и способ оценки. Досмотры CTV не заменяют такой дизайн, а маржа и ROAS отвечают за другой слой результата. Определения baseline, holdout и incrementality, а также хаб измерения помогают выбрать следующий доказуемый вопрос.