Решение зависит от того, какую модель вы собираетесь запускать
У разработчика рекламного ранжирования есть базовая модель: она оценивает товары или объявления и помогает выбрать порядок предложений. Появляется идея добавить описание назначения товара. На небольшом наборе данных новая версия ошибается чаще. В календаре релиза остаётся один свободный день, и соблазн закрыть задачу велик.
Но вопрос бизнеса относится к будущей рабочей модели, обученной на доступных ей данных. Результат уменьшенного опыта отвечает на более узкий вопрос. Между ними нужна проверяемая связь. Она может оказаться устойчивой, слабой или вообще отсутствовать. Решение «масштабировать» должно опираться на эту связь, а не на надежду, что большая нейросеть всё исправит.
Одна малая точка не описывает всю зависимость; сравнение требует одинакового способа оценки; прогноз нужно испытать на точке, не участвовавшей в его построении. Даже хороший прогноз модельной ошибки оставляет открытыми задержку ответа, стоимость обслуживания и результат рекламы. Эти проверки выполняют отдельно.
Что показала новая работа и где заканчивается её доказательство
В препринте Exploiting Feature-invariant Scaling Laws от 10 ноября 2026 исследователи Meta и Национального университета Сингапура разбирают изменения рекомендательных моделей на разных масштабах обучения. Они проверяют семейства Wukong, HSTU и модели на основе LLM. В отдельных опытах знак различия между базовой и новой версией меняется по мере увеличения масштаба. Авторы предлагают отбор изменений по серии малых обучений со статистическим прогнозом полного масштаба.
У метода есть показанная граница: добавление жанровых сведений к малой Qwen-0.5B нарушило предполагаемую форму зависимости. Объяснение авторов связано с недостаточной ёмкостью модели при расширении контекста. Это препринт об оценке моделей, включая MovieLens, а не доказательство рекламного роста российской платформы. Точность прогноза и экономию вычислений для своей системы придётся проверить отдельно.
Для рекламной команды полезен сам вопрос, поднятый работой: показывает ли малое обучение, какая из версий модели будет лучше после полного обучения? Дальше приведён собственный протокол такой проверки. Он не воспроизводит исследовательский алгоритм авторов и не обещает его результаты.
Назовите ось масштаба до первого запуска
Слово «маленький» скрывает разные изменения. Можно уменьшить число обучающих записей, число параметров, длину истории или время обучения. Если одновременно сократить всё, результат станет трудно объяснить. Новая модель могла проиграть из-за нехватки примеров, обрезанного описания товара или недоученного состояния.
Запишите, что именно меняется между опытами. Например: одинаковая архитектура, одна версия признаков, растущий объём исторических записей и согласованный режим обучения. Или одинаковые данные при разных размерах модели. Для совместного изменения размеров и данных нужен отдельный план. Нельзя подписать его график просто «больше вычислений» и забыть, что состав задач тоже изменился.
В документации scikit-learn кривые обучения связывают оценку с размером обучающей выборки и помогают увидеть характер ошибок. Это справочная основа для диагностики. Она не превращает любую гладкую линию в надёжный прогноз за пределами проверенных данных.
Практическая карточка масштаба содержит единицу, размер выборки, число параметров, предел длины входа, правило остановки и фактические вычислительные затраты. Если одна из этих величин поменялась незаметно, точку следует пометить как отдельный режим. Объединять её с остальными лишь ради красивой кривой опасно.
Три учебные точки меняют первоначальное решение
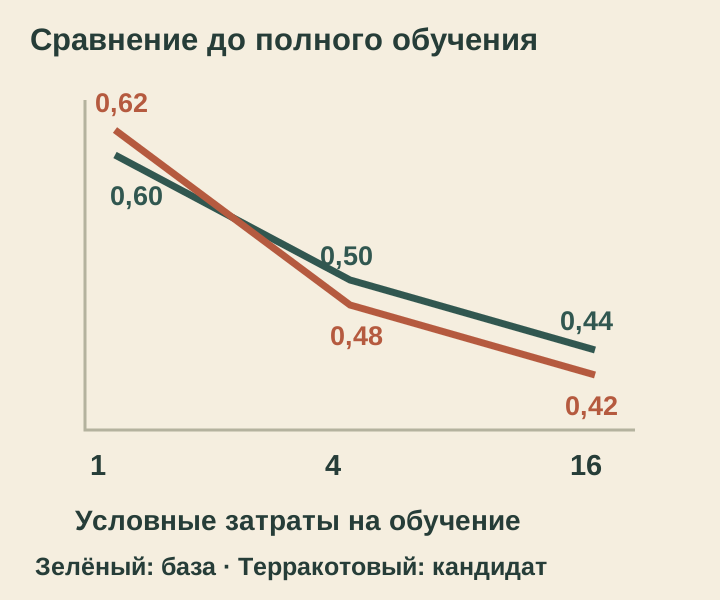
Возьмём вымышленную метрику ошибки: меньше означает лучше. Её значения служат только для объяснения. Это не CTR, не рубли и не числа из препринта. Базовая версия при условных затратах 1, 4 и 16 получает ошибку 0,60, 0,50 и 0,44. Новая версия получает 0,62, 0,48 и 0,42.
В первой точке кандидат хуже на 0,02. Во второй и третьей лучше на 0,02. Если закрыть идею после первого опыта, решение относительно последнего проверенного масштаба окажется неверным. Но эти три числа ещё не доказывают, что разница сохранится при затратах 64. Дальняя точка остаётся неизвестной.
Исходные учебные данные позволяют пересчитать каждую разность. В файле `compute_units` обозначает условные вычислительные единицы, а не число GPU или часы аренды. Для своего проекта замените и единицу, и значения, сохранив сведения об условиях каждого прогона.
Обратите внимание на два разных решения. «Первого опыта недостаточно для окончательного отказа» следует из примера. «Новая версия обязательно выиграет в промышленном запуске» из него не следует. Хороший исследовательский план умеет оставить задачу открытой с понятной стоимостью следующего шага.
Сделайте сравнение честным до построения линии
Разделите данные по времени так, чтобы проверяемые события происходили после обучающих. Зафиксируйте список допустимых записей. Нельзя дать новой модели более свежие покупки, а базовой старую историю и назвать разность архитектурным улучшением. Для рекламного ранжирования особенно важны момент доступности признака и задержка получения заказа.
Проверяйте обе модели на одном наборе и одной версии целевого события. Если «покупка» в одной выгрузке означает создание заказа, а в другой оплату, зависимость ошибки отражает смену определения. Такие разногласия сначала разбирают через словарь рекламных данных.
Запуски с разными случайными начальными состояниями помогают увидеть разброс обучения. Один результат без повтора не показывает, насколько он устойчив. Число повторов выбирают по стоимости и наблюдаемому шуму; универсального количества для всех систем нет. Сохраняйте все запуски, включая неудачные, и заранее определите, как обрабатывается техническое падение.
Отдельно проверьте полноту товарных описаний. Новое поле может быть заполнено лишь у части ассортимента. Тогда общий результат скрывает два режима: модель получила дополнительную информацию или получила пропуск. Полезно увидеть качество на этих частях, сохранив общий итог. Выбирать только удачный срез после просмотра результата нельзя.
Оставьте один масштаб для проверки собственного прогноза
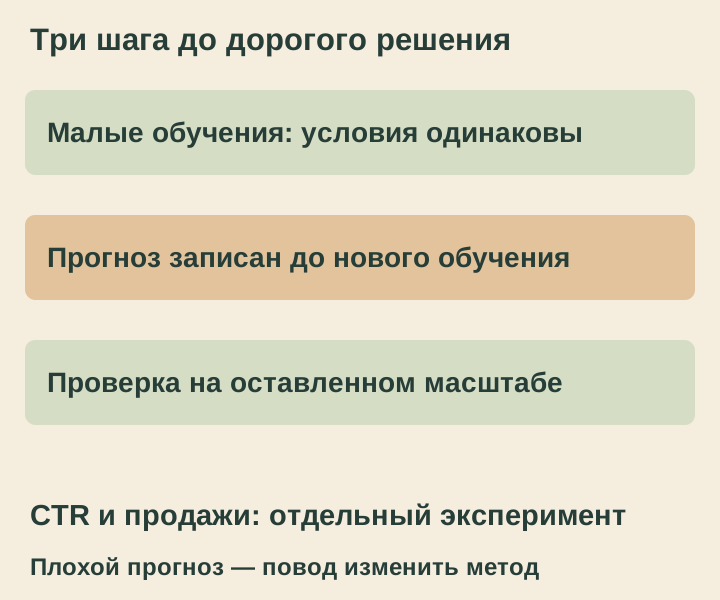
Предположим, команда выбрала форму зависимости и построила прогноз на первых масштабах. До обучения на следующем масштабе запишите ожидаемый диапазон результата, знак различия и правило решения. Затем проведите обучение и сравните ожидание с фактом. Именно такой порядок отделяет проверку прогноза от подгонки известного ответа.
Если фактическая точка резко отклоняется, сначала ищите смену режима: другая подготовка данных, предел памяти, обрезка входа, ограничение числа шагов, ошибка сохранения модели. После исключения технических причин пересмотрите саму форму зависимости. Уверенность, основанная на неверной форме, не становится полезнее от узкого интервала.
Не выбирайте форму только по совпадению с теми точками, на которых её строили. Через несколько наблюдений можно провести много убедительных линий. Для принятия решения важнее ошибка прогноза на оставленной точке и поведение при повторных обучениях. При большой неопределённости допустимый итог исследования: «данных недостаточно, нужен ещё один масштаб».
Сохраните прогноз рядом с датой его создания. Если после получения новой точки старый файл переписывается, команда теряет возможность оценить свой метод отбора. История таких проверок со временем становится полезнее единичного удачного графика: видно, какие изменения он предсказывает, а какие систематически пропускает.
Отделите цену обучения от цены рекламного ответа
Расход на исследование складывается из подготовки данных, запусков, повторов, анализа и проверки на большем масштабе. Экономия возникает лишь относительно заранее названного альтернативного плана. Если без метода команда обучила бы две версии, а с методом запустила десятки малых опытов, сумму нужно посчитать целиком.
Рабочая модель затем обслуживает рекламные запросы. Дополнительное поле может повысить точность, но потребовать нового обращения к хранилищу. Измерьте время ответа в обычном режиме и при нагрузке, долю тайм-аутов, расход памяти, стоимость обновления признаков. В рекламном аукционе поздний полезный ответ может не участвовать в выборе вовсе.
Для российского ритейлера разумный сценарий начинается с одной категории, в которой уже есть согласованные определения события и стабильная выгрузка. Владелец данных отвечает за доступность признаков, ML-инженер за обучение, аналитик за сравнение, команда рекламной выдачи за проверку времени ответа. Это распределение ответственности должно существовать до решения о внедрении.
Не следует переводить улучшение ошибки напрямую в проценты заказов. Даже при прежней аудитории изменившийся порядок товаров может перераспределить показы между продавцами и категориями. Деловой результат зависит от цены, наличия, маржи и механики аукциона. Модельная оценка помогает отбирать кандидатов для следующей проверки, но не заменяет её.
Когда стоит остановиться ещё до большого обучения
Первый повод остановки: обнаружена недоступная при реальном запросе информация. Например, признак включает итог покупки, который появился позже момента показа. Увеличение масштаба лишь улучшит работу с этой подсказкой и сделает ошибочный результат убедительнее. Такой кандидат возвращается на подготовку данных.
Второй повод: преимуществу требуется неприемлемое время ответа или недоступный источник. Если модель не успевает ответить в установленное время, исследование должно учитывать другую архитектуру или предварительный расчёт. Нельзя сохранять выигрыш метрики, мысленно вычеркнув из него все операционные ограничения.
Третий повод: различия между повторными запусками сопоставимы с наблюдаемым выигрышем, а доступного бюджета не хватает их уточнить. Это основание отложить решение. Оно отличается от вывода, что новая идея бесполезна. Сохранённые данные и вопрос к следующему опыту позволят вернуться к ней без повторения всей работы.
Инженерный контекст дополняют Rules of Machine Learning: качество данных и расхождения между обучением и обслуживанием требуют самостоятельной диагностики. Здесь зарубежный справочник используется как набор проверок разработки, без рекомендации покупать рекламу через недоступные российскому рынку продукты.
Карточка решения для команды и руководителя
На встречу о следующем этапе принесите одну страницу: какую гипотезу проверяли, что изменили, как определили масштаб, какие точки получили, где проверили прогноз и сколько стоит следующий шаг. Рядом укажите нерешённые вопросы. Руководителю не нужен перечень названий архитектур, чтобы понять, за что предлагается заплатить.
Решение «продолжить» сопровождается следующей проверяемой точкой. Решение «остановить» называет причину: качество данных, вычислительная стоимость, плохой прогноз или эксплуатационное ограничение. Решение «проверить на пользователях» требует отдельного экспериментального плана с метриками бизнеса и правилами остановки. Эти исходы нельзя объединять в зелёную отметку «модель прошла».
При передаче подрядчику запросите результаты каждого масштаба и повторов, неизменяемый проверочный набор, журнал версий признаков и прогноз, сделанный до следующего обучения. Отсутствие этих материалов не доказывает плохое качество подрядчика, но делает его вывод непроверяемым для заказчика. Заказчику остаётся покупать обещание вместо понятной процедуры.
После такой проверки команда понимает, какие решения можно принимать по малому обучению. Команда понимает, когда он позволяет отказаться от изменения, когда оставляет сомнение и когда оправдывает более дорогую проверку. Уверенность появляется из последовательности проверок, а не из размера модели в презентации.
Продолжить помогут материалы об отборе аукционных наблюдений, качестве набора испытаний агента и правилах остановки пилота. В глоссарии: базовый вариант, измерение, бизнес-результат. Обновление исследования следует искать по точному названию и версии препринта, указанным в источниках.